AI와 함께하는 교통문제 해결을 위한 데이터 분석 공모전 / 공공 정책
교통 사막: K-패스 혜택이 닿지 않는 지역
대중교통 환급 제도 K-패스의 혜택이 대중교통이 부족한 지역에는 거의 돌아가지 않는다는 걸 숫자로 보이고, 분담률이 낮은 요인을 모델로 나눠 보고 지역 유형마다 다른 지원책을 제안했습니다.
공공 정책의 성과는 예산이 정말 필요한 사람에게 닿는지에 달려 있습니다. K-패스는 탄 만큼 돌려주는 제도라, 인구의 17.4%가 사는 교통 사막에는 환급의 약 4.8%만 돌아가는 것으로 추정됐습니다.
요인을 지역마다 나눠 보니 가장 큰 요인은 인구밀도였고, 탈 대중교통이 없는 농산어촌형은 모형에서 자가용을 줄여도 분담률이 거의 오르지 않았습니다. 이 결과에 맞춰 유형마다 이동 크레딧(연 176억 원)과 전환 보너스(연 49억 원)를 다르게 제안했습니다. 교통 사막 기준을 바꿔도, 2026년 실제 이용자 수와 비교해도 결론이 유지되는 것을 확인했습니다.
01문제 정의
K-패스는 버스와 지하철을 타면 요금 일부를 돌려주는 제도입니다. 그런데 돌려받으려면 먼저 대중교통을 타야 합니다. 버스가 드물고 지하철이 없는 지역 주민은 혜택을 받을 기회 자체가 적습니다.
- K-패스 혜택은 지역마다 고르게 돌아가는가
- 대중교통을 덜 타는 지역은 왜 덜 타는가
- 그 이유가 지역마다 다르다면, 지원책도 달라야 하는가
분석 단위는 2020년 행정구역 기준 전국 229개 시군구입니다. 종속변수는 K-패스 대상 수단(시내, 마을, 광역버스, 전철, 지하철)의 통근, 통학 분담률이고, 이 값이 10% 미만인 시군구를 교통 사막으로 정의했습니다.
02데이터
| 자료 | 출처 | 용도 |
|---|---|---|
| 이용 교통수단별 통근, 통학 인구 (2020) | KOSIS 인구총조사 | 종속변수, 승용차 통근 비율 |
| 주민등록인구, 세대수, 연령별 인구 | KOSIS 행정안전부 | 인구, 고령 비율 |
| 자동차 등록, 국토이용현황 | KOSIS 국토교통부 | 자가용 보유, 대지 기준 인구밀도 |
| 버스정류장 위치, 버스노선과 배차간격 | 공공데이터포털 국토교통부 TAGO (API로 직접 수집) | 버스 공급 수준 |
| 도시철도역사 정보 | 공공데이터포털 | 철도 접근성 |
| K-패스 시도별 이용자 수 (2026.4) | 국토교통부 공개 자료 | 외부 검증 |
원자료를 시군구 단위로 맞추며 63개 변수를 만들었습니다. 정류장과 역은 좌표를 행정구역 경계에 겹쳐 시군구마다 셌습니다.
03혜택 격차
교통 사막 111곳에 인구의 17.4%가 살지만 환급액은 약 4.8%만 돌아가는 것으로 추정됩니다. 실제 지급 자료가 아니라 1인당 환급액이 같다고 가정해 계산한 값입니다. 주민 1인당 혜택은 분담률 20% 이상인 70곳이 교통 사막의 약 5.3배입니다.
04예측 모델
변수 고르기
63개 변수에서 VIF로 서로 겹치는 변수를 빼고 영역별로 7개를 남겼습니다. 비슷한 변수가 함께 들어가면 나중에 SHAP 기여도가 둘로 나뉘어 해석이 흐려지기 때문입니다.
| 변수 | 영역 | VIF |
|---|---|---|
| 대지 기준 인구밀도 (로그) | 밀도 | 6.23 |
| 정류장 밀도 (로그) | 공급 | 1.08 |
| 인구 10만 명당 도시철도역 | 공급 | 1.62 |
| 인구 1천 명당 자가용 | 자동차 | 1.65 |
| 시도 밖으로 통근하는 비율 | 이동 구조 | 1.53 |
| 고령 비율 | 교통약자 | 9.25 |
| 청소년 비율 | 교통약자 | 3.52 |
고령 비율은 VIF가 다소 높지만, 교통약자 지원이라는 정책 질문에 꼭 필요해 남겼습니다.
모델 비교
인구밀도 효과처럼 직선이 아닌 관계를 잡으려고 트리 모델 세 개를 5-fold 교차검증으로 비교했습니다. 229개는 작은 표본이라 한 번만 나누면 운에 따라 성능이 흔들립니다.
| 모델 | 교차검증 R² | R² 표준편차 | RMSE (%p) | MAE (%p) |
|---|---|---|---|---|
| RandomForest | 0.920 | 0.027 | 3.60 | 2.57 |
| GradientBoosting | 0.929 | 0.022 | 3.40 | 2.43 |
| ExtraTrees | 0.928 | 0.022 | 3.41 | 2.44 |
세 모델의 차이는 작았고, 오차가 가장 작은 GradientBoosting을 골랐습니다. 인구밀도 하나만 넣어도 R² 0.78이 나와서, 나머지 변수가 설명하는 부분은 0.15 정도입니다.
05SHAP으로 요인 분해
모델을 예측에 그치지 않고 진단에 썼습니다. SHAP은 시군구마다 "어떤 요인이 분담률을 몇 %p 올리거나 내렸나"를 계산해 줍니다. 변수가 7개라 가능한 조합(2⁷ = 128개)을 전부 계산하는 정확한 SHAP을 직접 구현했고, 기여도의 합이 예측값과 정확히 맞는지 확인했습니다.
인구밀도의 영향이 절반 이상이고, 다음이 자가용 보유와 도시철도역입니다. 정류장 수 자체의 영향은 작았습니다. 정류장 수보다 주변에 사람이 얼마나 모여 사는지가 더 크게 작용했습니다.
06교통 사막 유형 나누기
원래 변수 값으로 묶으면 "비슷하게 생긴 지역"이 묶입니다. 처방을 나누려면 대중교통을 안 타는 이유가 같은 지역끼리 묶어야 해서, 교통 사막 111곳을 SHAP 값으로 K-means 군집화했습니다.
| 군집 수 | 실루엣 | Davies-Bouldin |
|---|---|---|
| 2 | 0.523 | 0.824 |
| 3 | 0.437 | 0.894 |
| 4 | 0.325 | 1.182 |
| 5 | 0.310 | 1.030 |
지표만 보면 2개가 가장 좋았지만, 2개로 나누면 농촌형과 지방도시형이 한 묶음이 되어 처방이 하나로 뭉개졌습니다. 해석 가능성을 우선해 3개를 골랐습니다.
| 유형 | 지역 수 | 분담률 | 대지 인구밀도 | 자가용/1천 명 | 고령 비율 | 승용차 통근 |
|---|---|---|---|---|---|---|
| ① 농산어촌 이동고립형 | 67 | 4.7% | 3,928 | 356 | 33.2% | 49.6% |
| ② 도농복합 자동차의존형 | 32 | 6.4% | 6,503 | 402 | 22.6% | 61.4% |
| ③ 지방도시 자동차고착형 | 12 | 8.2% | 12,904 | 412 | 15.9% | 65.1% |
| (참고) 교통 사막이 아닌 지역 | 118 | 33.4% | 37,172 | 325 | 16.8% | 39.3% |
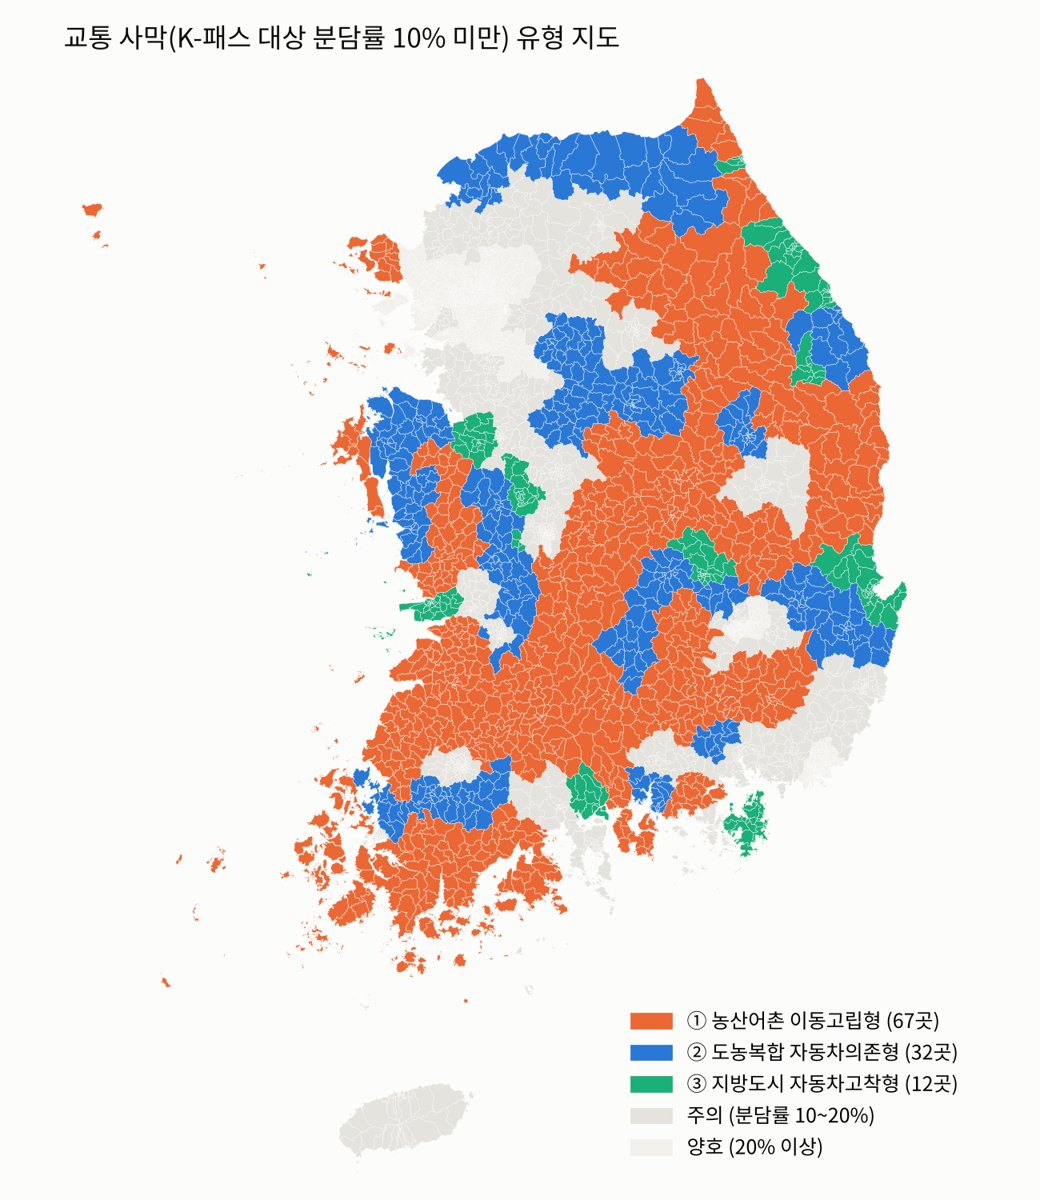
①은 고령층이 많고 차가 없는 사람도 많아 이동 자체가 어렵습니다. ②, ③은 자가용으로 출퇴근하는 비율이 60%를 넘어, 대중교통으로 바꾸게 하는 것이 핵심입니다. 분담률 자체도 이웃 지역끼리 매우 비슷해서 지도에서 무리 지어 나타났습니다(Moran's I 0.88). 개별 시군구보다 권역 단위 정책이 필요하다는 근거입니다.
07검증
교통 사막 기준을 바꿔도 결론이 같은가
| 기준 | 지역 수 | 인구 비중 | 혜택 비중 | 1인당 혜택 배율 | 10% 기준과 유형 일치도(ARI) |
|---|---|---|---|---|---|
| 8% | 94 | 11.5% | 2.6% | 6.6배 | 0.96 |
| 10% | 111 | 17.4% | 4.8% | 5.3배 | 1.00 |
| 12% | 127 | 26.4% | 9.2% | 4.2배 | 0.40 |
| 15% | 140 | 35.8% | 14.8% | 3.5배 | 0.38 |
혜택 격차(3.5~6.6배)는 어느 기준에서도 유지됐습니다. 다만 12% 이상에서는 유형 구성이 달라져서, 유형 분류는 10% 기준에 의존한다는 점을 한계로 밝혔습니다.
2026년 실제 이용자 수와 비교
통근 수단 자료는 2020년이 최신이라, 2020년 자료로 만든 모델을 최신 인구와 자동차 자료에 적용해 2026년 4월 시도별 실제 K-패스 이용자 수와 비교했습니다. 인구가 많은 시도일수록 이용자도 많아서 이용자 수를 그대로 비교하면 상관이 높게 나옵니다(0.94). 그래서 인구 1천 명당 기준 0.86(95% 구간 0.64~0.95, 시도 17곳)을 기준으로 봤습니다.
지역을 묶어 다시 검증
이웃 지역끼리 값이 비슷하면 무작위로 나눈 교차검증은 성능을 좋게 보이게 합니다. 한 시도를 통째로 빼고 나머지 시도로 학습해 그 시도를 맞히는 방식으로 다시 검증했습니다. 정류장 자료가 온전한 220곳 기준입니다.
| 검증 방식 | R² | RMSE (%p) | MAE (%p) |
|---|---|---|---|
| 무작위 5겹 | 0.93 | 3.5 | 2.5 |
| 시도 단위 (한 시도씩 제외) | 0.85 | 5.1 | 3.6 |
| 시도 단위, 인구밀도 하나만 | 0.73 | 6.8 | 4.7 |
- R²는 0.93에서 0.85로 내려갔습니다. 무작위 검증에서는 성능이 실제보다 높게 나왔던 셈입니다.
- 오차는 대도시에 몰렸습니다. 서울은 분담률을 평균 9.8%p 낮게 예측했고, 부산과 대구도 평균 오차가 6~7%p였습니다. 전남, 전북, 경북처럼 교통 사막이 많은 지역은 평균 오차가 1%p 안팎이었습니다.
- 교통 사막 여부(분담률 10% 미만)는 이 검증에서도 103곳 중 96곳(93%)을 맞혔습니다. 교통 사막을 가려내는 용도로는 결론이 유지됩니다.
08제안
| 대상 | 제안 | 규모 추정 |
|---|---|---|
| ① 농산어촌 이동고립형 | 선지급형 이동 크레딧. 버스를 잘 타지 않는 지역이라 사후 환급은 의미가 없어서, DRT(수요응답형 교통)나 택시에 쓸 수 있는 금액을 미리 지급 | 약 9.2만 명, 연 176억 원 (DRT 약 124대 운영비 규모) |
| ② 도농복합, ③ 지방도시 | 대중교통 전환 보너스. 자가용 통근자가 대중교통으로 바꾸면 추가 혜택 | 목표 약 2.6만 명, 연 49억 원, CO₂ 약 3.5만 t 감축 |
시나리오 분석에서 ①은 자가용이 줄어도 분담률이 거의 오르지 않았습니다. 탈 대중교통이 없어서입니다. ①에는 전환 보너스를 넣지 않았습니다. 전환 보너스의 2.6만 명은 목표치이고, 효과를 추정한 값은 아닙니다.
176억 원은 K-패스 첫 1년 환급금 3,600억 원(보도)에 ① 유형의 인구 비중과 혜택 비중의 차이 4.9%p를 곱한 값이고, 월 1.6만 원씩 지급하면 약 9.2만 명입니다. 49억 원은 목표 인원에게 같은 금액을 1년 지급하는 비용입니다.
09한계
- 통근 수단 자료가 코로나 시기인 2020년입니다. 이 점은 2026년 실제 이용자 수로 따로 검증했습니다.
- 시도 단위로 묶어 검증하면 R²가 0.93에서 0.85로 내려갑니다. 특히 서울은 분담률을 평균 9.8%p 낮게 예측해, 대도시에는 이 모델을 그대로 쓰기 어렵습니다.
- 교통 사막 기준을 12% 이상으로 올리면 유형 구성이 달라집니다.
- SHAP은 모델이 본 기여도이지 인과효과가 아닙니다.
- 환급액 1.6만 원, 연비, 통근 거리 같은 값은 보도와 가정에서 가져왔습니다.
10기술별로 왜 썼나
| TAGO API 수집 | 정류장 위치만으로는 서비스 수준을 알 수 없어서 노선 정보까지 모으려고 |
| VIF | 비슷한 변수가 함께 들어가면 SHAP 기여도가 나뉘어 해석이 흐려져서 |
| 로그 변환 | 인구밀도는 지역 간 차이가 수백 배라 극단값에 끌려가지 않게 하려고 |
| 트리 모델 3개 비교 | 직선이 아닌 관계를 잡고, "왜 그 모델이냐"에 숫자로 답하려고 |
| 교차검증 | 229개는 작아서 한 번만 나누면 운에 따라 성능이 흔들려서 |
| 정확한 SHAP | 변수가 7개라 모든 조합을 계산할 수 있고, 근사 없이 기여도 합이 예측값과 맞아서 |
| SHAP 값으로 군집화 | 대중교통을 안 타는 이유가 같은 지역끼리 묶어야 처방을 나눌 수 있어서 |
| K = 3 | 지표는 2가 최고였지만 2개로는 처방이 하나로 뭉개져서 |
| 기준 민감도 (8~15%) | 10%가 임의 기준이라는 반론에 결론이 유지된다는 걸 보이려고 |
| Moran's I, LISA | 교통 사막이 지도에서 무리 지어 있는지 확인하려고 |
| 2026년 이용자 수 검증 | 2020년 자료의 한계를 최신 외부 자료로 보완하려고 |
| CO₂와 예산 환산 | 정책 담당자는 R²가 아니라 예산과 효과로 판단해서 |